



-
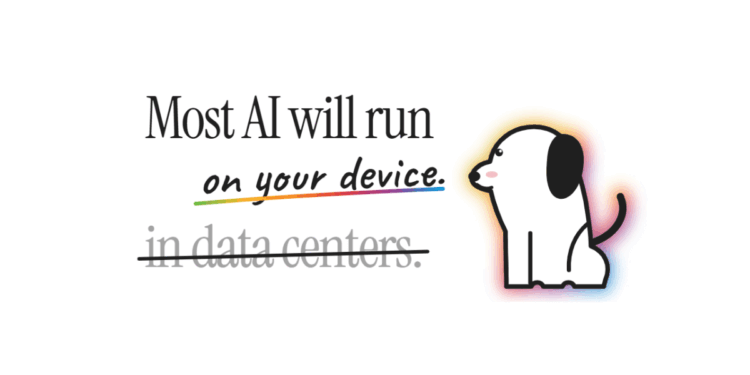
El modelo Underdog 27B opera en equipos Mac sin enviar información a centros de datos.
-
Su ejecución local mitiga los riesgos de filtración producto de hackeos.
El desarrollador Sigil Wen presentó Underdog, un conjunto de modelos de inteligencia artificial diseñados para ejecutarse localmente en los dispositivos de los usuarios en lugar de depender de centros de datos en la nube.
La versión principal, denominada Underdog 27B, está construida sobre la base de Qwen 3.8 27B y, según las métricas publicadas por el equipo creador el 1 de octubre, supera el rendimiento de Claude Opus 4.6, el modelo líder de la industria hace seis meses.
El sistema opera actualmente de manera nativa en computadoras Mac, mientras se encuentra en fase beta para Windows y desarrolla su compatibilidad para Linux, iOS y Android.
Este proyecto cuenta con financiamiento levantado a principios de 2026 de firmas de capital de riesgo como Andreessen Horowitz, Khosla Ventures y SV Angel.
La arquitectura de Underdog responde a una postura explícita sobre la privacidad y la ciberseguridad. Wen argumenta que la concentración de datos en servidores de terceros incrementa las probabilidades de explotación maliciosa y vulnerabilidades a gran escala.
Para sustentar esta premisa, el desarrollador citó incidentes recientes en la industria, incluyendo las brechas de seguridad sufridas por OpenAI y Hugging Face en julio de 2026.
Para evitar estos vectores de ataque, Underdog asegura que procesa toda la información en el hardware del usuario, manteniendo los datos cifrados en el dispositivo sin enviarlos a servidores externos para su análisis.
Este enfoque de ejecución local aborda directamente un problema operativo que afecta a sectores donde el secreto industrial y la seguridad informática son críticos. La dependencia de plataformas de terceros genera un riesgo de custodia sobre la información ingresada, una dinámica que ha despertado advertencias recientes.
Tal como lo ha mencionado CriptoNoticias, en el ecosistema de Bitcoin, este riesgo de exposición adquiere proporciones económicas directas.
Si un desarrollador utiliza una inteligencia artificial comercial para redactar código inédito o auditar un borrador sobre una falla del protocolo, cede el control de esa información a la empresa operadora.
La revelación prematura de una vulnerabilidad de Bitcoin a través de los servidores de estas plataformas abriría una ventana de explotación antes de que exista un parche, lo que podría comprometer fondos reales y quebrar las prácticas de divulgación responsable de la comunidad.
El conflicto de septiembre de 2026, donde se cuestionó si OpenAI utilizó sesiones privadas de investigadores para que el modelo GPT-6 Astra resolviera las ecuaciones de Navier-Stokes, evidenció la imposibilidad de auditar externamente el uso de datos en inteligencias artificiales comerciales.
Ante la falta de mecanismos de verificación independientes sobre el destino de la información sensible, el despliegue de modelos eficientes que puedan correr en el hardware propio del usuario se perfila como la principal vía tecnológica para que los desarrolladores de Bitcoin utilicen estas herramientas sin delegar la confianza en entidades privadas.
 Guarda lo que vale la pena descifrar