



-
El controlador vardiff solo recalcula la dificultad cuando recibe un share del minero.
-
Un minero que reduce potencia deja de producir shares al ritmo que el pool espera.
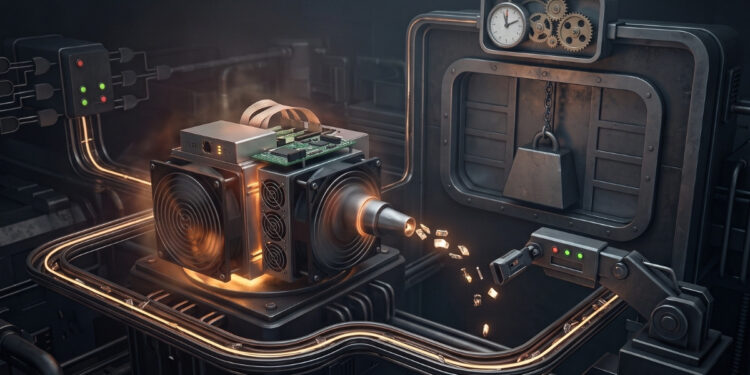
Un análisis técnico publicado en Delving Bitcoin describe una falla estructural en la forma en que los pools de minería ajustan la dificultad de trabajo de cada minero. Cuando un equipo reduce su potencia de forma deliberada, el mecanismo que debería adaptarse a esa bajada puede quedarse ciego justo en el momento en que más lo necesita, dejando al minero produciendo casi nada pese a seguir conectado y consumiendo energía.
Cada vez que un equipo de minería se conecta a un pool, recibe una dificultad de trabajo particular, distinta de la dificultad de la red. Esa dificultad determina qué tan «fácil» debe ser el resultado que el equipo encuentre para poder reportarlo como un share, una especie de prueba parcial de trabajo que certifica que el minero está aportando potencia de cómputo real.
El software encargado de fijar esa dificultad se llama controlador de dificultad variable, o vardiff. Su lógica es simple en apariencia: si el minero envía shares muy rápido, sube la dificultad; si los envía muy lento, la baja. El objetivo es mantener un flujo de shares parejo sin saturar al pool ni dejar al minero sin forma de reportar su trabajo.
Aquí es donde Eric Price, autor del análisis en Delving Bitcoin, identifica el defecto. Muchos de estos controladores solo recalculan la dificultad cuando reciben un share nuevo. Si el minero reduce su potencia —por una respuesta a demanda eléctrica, calor excesivo o una decisión operativa— sus shares empiezan a escasear, y con ellos desaparece la única señal que el controlador usa para bajar la dificultad.
La tesis central del análisis es que este no es un problema de mala calibración, sino de diseño: un controlador que solo escucha shares queda mudo justo cuando el minero más necesita que le bajen la dificultad. Ajustar ventanas de tiempo, márgenes de tolerancia o la agresividad del ajuste no cambia nada, porque no existe información que extraer de un flujo de shares que simplemente dejó de llegar.
El ciclo que atrapa al minero
El resultado es lo que Price llama un minero «varado». La dificultad queda fija en el nivel calculado para la velocidad anterior del equipo, así que cada nuevo intento de encontrar un share resulta mucho más difícil de lo que debería. El minero produce una fracción de lo que le correspondería, y esa escasez de shares es precisamente lo que impide al controlador notar el problema y corregirlo.
El mecanismo se retroalimenta a sí mismo:
- La dificultad demasiado alta reduce la frecuencia de shares.
- La falta de shares deja al controlador sin evidencia del cambio.
- Sin evidencia, el controlador no actúa y mantiene la dificultad.
- La dificultad sigue alta, y el ciclo se repite.
El costo recae sobre el minero: sigue hasheando a plena potencia y pagando el consumo eléctrico correspondiente, pero su contribución reconocida por el pool colapsa. Bajo esquemas de recompensa proporcional, incluso puede terminar cediendo parte de esa pérdida a otros mineros del mismo pool, sin que nadie del lado del pool note la diferencia entre un equipo varado y uno que simplemente se desconectó.
La salida: un temporizador que actúe sin shares
La solución que propone Price no depende de mejorar la puntería del controlador, sino de darle una segunda vía para actuar. Se trata de un temporizador que reduce la dificultad en intervalos fijos, sin esperar a que llegue un share. Si pasó un tiempo determinado sin noticias del minero, el controlador asume que probablemente bajó su ritmo y ajusta la dificultad hacia abajo por su cuenta.
Este esquema, según el análisis, ya funciona en la implementación de referencia de Stratum V2, el protocolo de comunicación entre mineros y pools pensado para descentralizar el control sobre la construcción de bloques. Ese controlador recalcula en cada intervalo del reloj, no solo cuando llega un share, así que nunca queda completamente ciego ante un minero que se ralentiza. La limitación, reconocida en el propio análisis, es que la recuperación puede ser lenta en canales que llevaban mucho tiempo funcionando de forma estable, porque el historial acumulado de shares «sanos» pesa más al momento de recalcular.
| Tipo de controlador | Reacciona solo a shares | Reacciona también a un temporizador | Resultado ante una baja sostenida |
|---|---|---|---|
| Disparado por shares | Sí | No | Queda fijo en la dificultad anterior |
| Cuantizado (por escalones) | Sí | No | Puede quedar atascado incluso con shares |
| Con temporizador (Stratum V2) | Sí | Sí | Reduce la dificultad de forma gradual |
De un minero a un pool entero: el problema en redes con proxy
Un intercambio posterior con el desarrollador Anthony Towns, recogido en un hilo posterior en Delving Bitcoin, llevó el problema un paso más allá. En despliegues reales, los mineros no suelen conectarse directamente al pool, sino a un proxy o gateway local que agrupa el trabajo de muchos equipos antes de enviarlo hacia arriba. Esto ocurre tanto en instalaciones que usan Stratum V2 como en las que usan DATUM, un protocolo alternativo que permite a cada operador construir sus propios bloques candidatos en lugar de depender del pool para esa tarea.
El problema, planteó Towns, es que el pool ya no ve a cada minero individual: solo ve el total agregado de todos los equipos detrás del proxy. Si uno de ellos se ralentiza, esa caída puede quedar diluida en la suma general y volverse invisible para el pool, aunque siga siendo perfectamente visible para el proxy que está en contacto directo con ese minero.
Price coincidió con ese planteo y sostuvo que el control de dificultad por minero individual debe resolverse en el último punto de la red que todavía observa los shares de ese equipo en particular: el proxy o el gateway, no el pool central. Es una división de responsabilidades más que un traslado del problema: el pool sigue gestionando la dificultad agregada, mientras que la detección fina de una baja individual queda a cargo de la infraestructura más cercana al minero.
El hardware no basta si la lógica de ajuste falla
Lo que este caso deja claro es que la eficiencia de una operación minera no se mide solo en potencia instalada o eficiencia energética de los chips. Un equipo puede estar hasheando de forma óptima y aun así producir una fracción de lo que le corresponde, simplemente porque la lógica del pool que lo atiende nunca aprendió a leer el silencio como una señal.
Para un minero individual, la lección práctica es simple: la ausencia de shares no es un problema que se resuelva solo, y ni el pool ni el propio equipo tienen, por diseño, una forma automática de detectarlo si el controlador que los conecta no fue construido para actuar sin esa señal.

 Guarda lo que vale la pena descifrar